OpenAI a lancé deux modèles GPT-6.2 le 17 novembre 2026, et la paire est conçue pour être achetée ensemble : Sol est le modèle quotidien rapide et bon marché, Astra le modèle coûteux et plus lent pour les tours qui en ont vraiment besoin. Chaque chiffre ci-dessous a été lu sur la documentation des modèles et la page de tarification d'OpenAI, ainsi que sur la suite de benchmarks d'Artificial Analysis, le 18 novembre 2026. Les pages de tarification répondent directement à la question d'achat : même fenêtre de contexte, mêmes outils, mêmes limites de débit, et un écart de prix de 4x sur chaque token.
Ce qu'OpenAI a réellement livré, avec ses propres mots
La documentation officielle donne à chaque modèle une phrase de rôle. gpt-6.2-astra est le « modèle phare pour les projets d'ingénierie, scientifiques et professionnels les plus difficiles » ; gpt-6.2-sol est le « modèle quotidien efficace pour le codage, la revue de code et les workflows agentiques à grande échelle ». Rien dans la documentation ne les présente comme des rivaux. Ce sont le slot de raisonnement profond et le slot de haut volume d'une même gamme, et les deux partagent le même corps : 1 050 000 tokens de contexte, 922 000 d'entrée max, 128 000 de sortie max, entrée texte et image avec sortie texte, et des limites de débit identiques de 5 000 à 15 000 RPM selon le palier.
Deux différences plus discrètes méritent une lecture avant de choisir. Le cutoff de connaissances de Sol est le 1er juin 2026, deux semaines plus récent que celui d'Astra (18 mai). Et à partir de GPT-6.2, l'API supprime les reasoning items dès qu'elle détecte une modification de préfixe en cours de conversation, un déclassement de modèle, un changement d'utilisateur final ou d'organisation, donc une session qui garde son préfixe de prompt identique octet par octet garde à la fois son raisonnement et ses remises de cache de prompt.
Ce que chacun coûte, y compris les paliers que personne ne lit
La page de tarification se divise par palier de traitement, et l'écart entre les modèles se maintient à chaque palier. Le tableau tarife le palier Standard ; le diagramme ci-dessous porte les cinq.
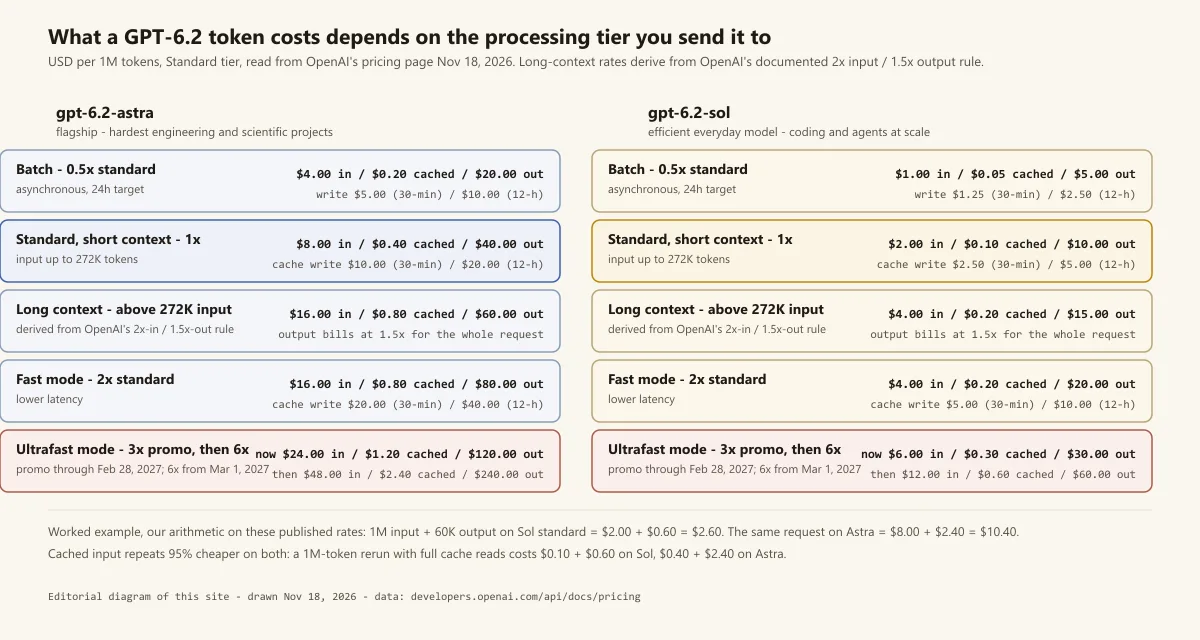
Trois rangées de cet escalier méritent une seconde lecture. D'abord, l'entrée en cache se répète à 95 % de réduction sur les deux modèles : un rerun sur un préfixe d'un million de tokens en cache coûte 0,10 $ sur Sol et 0,40 $ sur Astra, voilà pourquoi la règle de stabilité du préfixe est aussi un levier de prix, pas seulement une règle de correction. Ensuite, le contexte long au-delà de 272K tokens d'entrée double les tarifs d'entrée et facture la sortie à 1,5x pour toute la requête, c'est la règle documentée d'OpenAI ; les chiffres par million du diagramme en dérivent arithmétiquement, pas d'une rangée inventée. Enfin, le mode ultrafast est à un tarif promotionnel de 3x jusqu'au 28 février 2027 et passe à 6x à partir du 1er mars 2027. Un budget construit sur les prix ultrafast d'aujourd'hui double le 1er mars.
Ce que montrent les benchmarks tiers, et leurs limites
Artificial Analysis a fait passer les deux modèles par son Intelligence Index v5.0.1 en effort Max, et les deux battent leurs prédécesseurs sur chaque axe mesuré par sa suite.
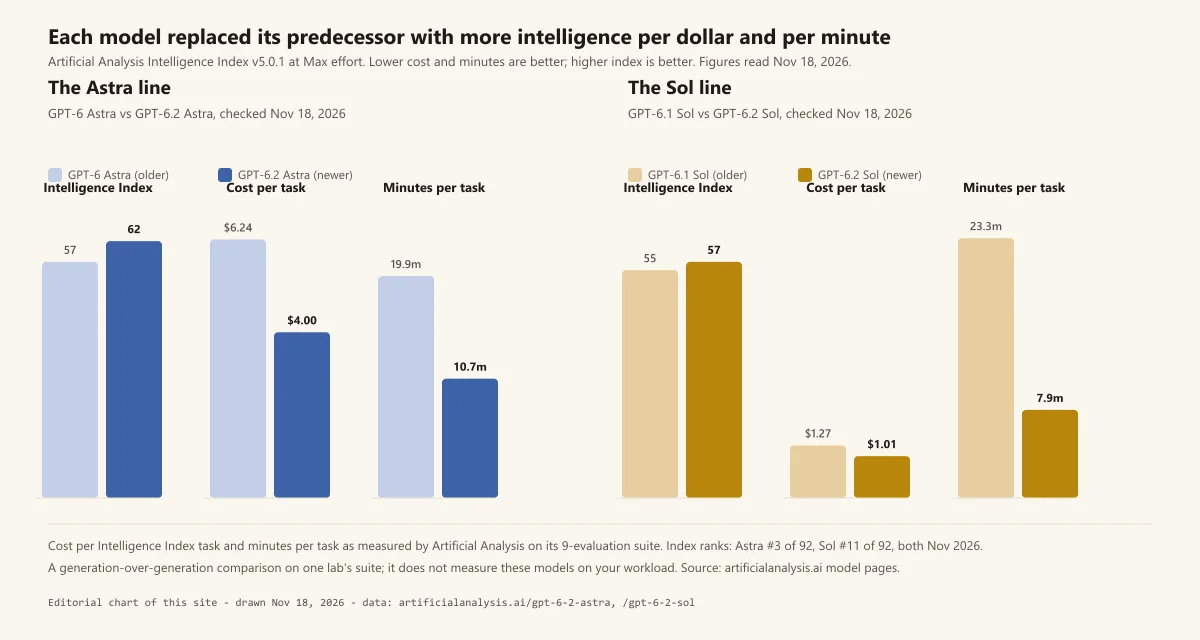
Astra marque 62, rang #3 sur 92 modèles, contre 57 au rang #13 pour GPT-6 Astra. Sol marque 57, rang #11, contre 55 au rang #19 pour GPT-6.1 Sol. L'histoire générationnelle est plus nette que le classement : Sol à 57 égale exactement ce que le modèle phare précédent marquait, et il le fait à 1,01 $ par tâche d'index contre 6,24 $ pour l'ancien phare. Les 4,00 $ d'Astra par tâche sont une baisse de 36 % depuis 6,24 $, tout en parcourant la suite en 10,7 minutes au lieu de 19,9. Sol parcourt 7,9 minutes par tâche à 85 tokens par seconde de sortie, avec un premier token de réponse en 61,56 s là où Astra prend 147,65 s.
La médiane de la suite est 43 sur l'index et 11,4 minutes par tâche, donc les deux modèles sont bien au-dessus de la médiane et tous deux plus lents que la médiane par tâche. C'est la forme d'un modèle à raisonnement intensif mesuré sur une suite de raisonnement. Ce que la suite ne fait pas, c'est mesurer ces modèles sur votre code : l'index à 9 évaluations d'un seul laboratoire est une preuve sur les modèles, pas sur votre charge de travail, et la façon honnête de l'utiliser est de lancer les deux prompts qui vous importent vraiment avant de décider où va le budget.
Comment répartir une charge de travail sur la paire
L'économie pointe dans un sens et l'écart de prix pointe dans le même. Sol gère le volume quotidien : revue de code, runs de refactor, boucles agentiques où le coût par appel se cumule à 85 tokens par seconde. Astra prend les tours où la réponse de Sol n'est pas assez bonne : la décision d'architecture, l'investigation multi-fichiers, la revue sensible à la sécurité. Escaladez tour par tour, rejouez le tour échoué sur Astra une fois, puis revenez ; ne migrez pas toute la session, car un changement de modèle en cours de conversation est l'un des quatre événements qui suppriment les reasoning items et réinitialisent le cache de prompt.
Un exemple calculé aux tarifs Standard, notre arithmétique sur les prix publiés d'OpenAI : une requête sur un préfixe d'un million de tokens avec 60 000 tokens de sortie coûte 2,00 $ + 0,60 $ = 2,60 $ sur Sol et 8,00 $ + 2,40 $ = 10,40 $ sur Astra. La même requête rejouée sur un cache chaud coûte 0,10 $ + 0,60 $ sur Sol, 0,40 $ + 2,40 $ sur Astra. Multipliez par le volume d'appels que vos agents exécutent réellement, et la différence entre un bon routage et un mauvais est la ligne entière du budget.
Pour qui chacun n'est pas fait
Astra n'est pas fait pour les boucles agentiques à haut volume, où un prix d'entrée 4x et un prix de sortie 4x se cumulent en une facture que la parité de benchmark de Sol ne peut pas justifier. Sol n'est pas fait pour les tours frontier : son 57 sur l'index égale le modèle phare de la génération précédente, ce qui est remarquable, mais il est cinq points sous Astra, et sur le tour qui décide de l'architecture ces cinq points sont le produit.
Notre catégorie codage IA suit les éditeurs et agents auxquels ces modèles se branchent, les profils ChatGPT, GitHub Copilot, et Cursor portent les chiffres sourcés des outils eux-mêmes, notre comparaison Claude vs Gemini tarife la paire frontier concurrente, et le guide Claude Code vs Cursor couvre la couche où le choix du modèle rencontre le choix de l'éditeur. La comparaison Gemini 4 Carbon vs Hydrogen est la même analyse pour la gamme de Google, et Gemini 4 Krypton couvre ce que le checkpoint rapporté mais non confirmé de Google prouve et ne prouve pas.