Anthropic ra mắt Claude Fable 5.2 ngày 9 tháng 11 năm 2026, và câu hữu ích nhất trong tài liệu của chính hãng không nói về mô hình. Nó nói về cách định tuyến: hãy bắt đầu phần lớn công việc coding và tri thức trên Claude Opus 5.5, rồi chuyển lên Fable 5.2 khi tác vụ xứng đáng với giá đó. Mọi số liệu dưới đây được đọc từ model docs, tài liệu giá và bài công bố của Anthropic, cùng bộ đo độc lập của Artificial Analysis, vào ngày 19 tháng 11 năm 2026.
Anthropic ra mắt gì, và mô hình anh em rẻ hơn mua được gì
Fable 5.2 là flagship thế hệ thứ sáu cho suy luận nặng và công việc agentic dài hơi, với cửa sổ context 1 triệu token và 128 nghìn token output. Mô hình nhận văn bản và hình ảnh, trả về văn bản. Dữ liệu huấn luyện và ngưỡng kiến thức đáng tin của nó đều ghi tháng 6 năm 2026, và Anthropic cam kết còn cung cấp mô hình ít nhất đến ngày 9 tháng 11 năm 2027.
Phần lớn người đọc bỏ qua mô hình anh em. Claude Mythos 5.2 là cùng một mô hình nền với cùng mức giá, và khác biệt nằm ở cổng truy cập chứ không ở năng lực: Fable phát cho mọi tài khoản kèm các lớp bảo vệ an ninh mạng và sinh học, còn Mythos chỉ giới hạn cho các tổ chức đã được xác minh qua Life Sciences và Cyber Verification Programs của Anthropic. Nếu công việc của bạn là an ninh tấn công hoặc thiết kế protein và bạn không nằm trong các chương trình đó, mô hình bạn mua được là Fable, và chính các lớp bảo vệ đó là lý do điểm trên các phép đánh giá an ninh mạng được công bố hai lần.
Giá đã giảm, và cầu thang quanh nó quan trọng hơn
Fable 5.2 tính 8 đô la mỗi triệu token input và 40 đô la mỗi triệu token output. Mức đó thấp hơn 20% so với 10 và 50 đô la của Fable 5.1, và mức giảm lặp lại trên mọi hàng của cầu thang cache: 10 đô la mỗi triệu cho cache write năm phút so với 12,50, 16 đô la cho cache write một giờ so với 20, và 0,20 đô la mỗi triệu cho cache read so với 0,25.
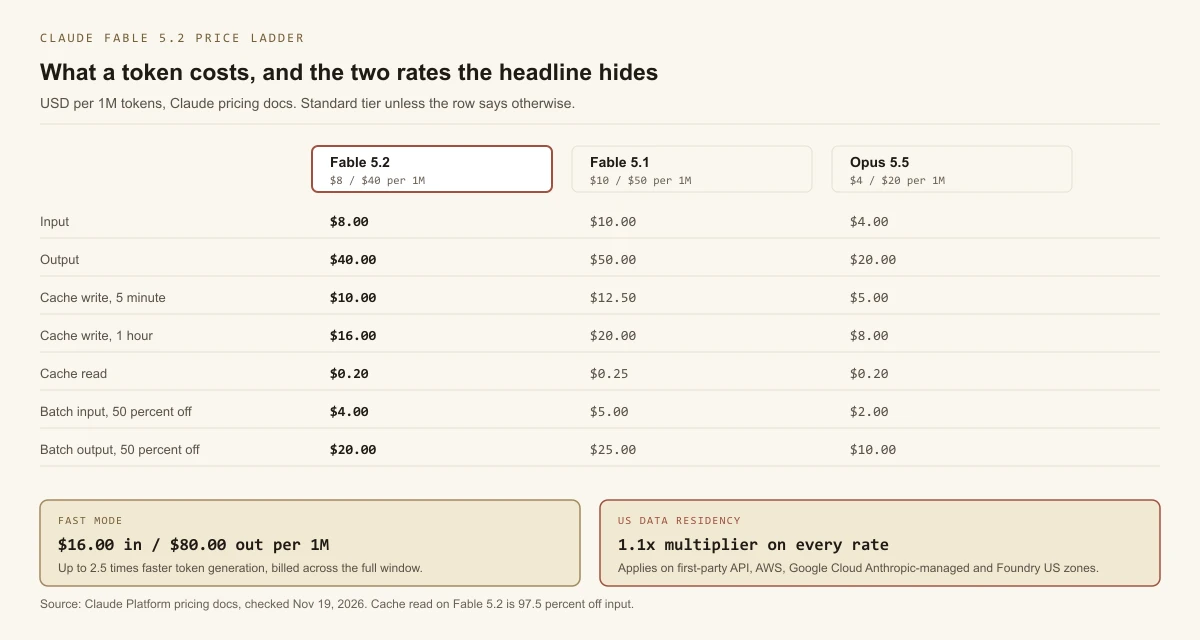
Ba hàng quyết định hóa đơn thật nhiều hơn mức giá tiêu đề. Thứ nhất, cache read rẻ hơn 97,5% so với giá input, nên một workload giữ ổn định prefix prompt chỉ trả 0,20 đô la thay vì 8,00 đô la cho mỗi triệu token đã cache, và đó là chỗ lời khuyên định tuyến thôi là câu chuyện chi phí và trở thành câu chuyện kiến trúc. Thứ hai, Batch API giảm 50% ở cả hai chiều, đưa công việc batch về 4,00 đô la input và 20,00 đô la output mỗi triệu, đúng mức Opus 5.5 tính khi chạy tương tác. Thứ ba, Fast mode tính 16 đô la input và 80 đô la output mỗi triệu để đổi lấy tốc độ sinh token nhanh hơn tới 2,5 lần, và nó áp trên toàn bộ cửa sổ context chứ không chỉ dưới một ngưỡng nào đó.
Một hệ số nữa không có hàng riêng: đẩy suy luận sang vùng địa lý chỉ dùng nước Mỹ tốn 1,1 lần mức giá niêm yết trên API chính chủ, Claude Platform on AWS, mô hình do Anthropic quản lý trên Google Cloud, và US Data Zone Standard của Microsoft Foundry. Một ngân sách giả định định tuyến toàn cầu sẽ hụt 10% ngay khi yêu cầu tuân thủ ghim vùng.
Phép so sánh có ý nghĩa thương mại là với Opus 5.5, mô hình tính 4 và 20 đô la với mức effort mặc định là medium, và với Sonnet 5.5 ở 2 và 10 đô la cùng Haiku 5.5 với giá từ 0,10 và 0,50 đô la. Fable 5.2 đắt gấp đôi Opus 5.5 ở input và gấp đôi ở output. Phần văn xuôi benchmark của chính Anthropic nói thẳng một cách hiếm thấy về việc đó mua được gì: ở effort High, Fable 5.2 đạt ngang Opus 5.5 ở effort Max với chi phí mỗi tác vụ khoảng một nửa. Hãy đọc câu đó hai lần, vì nó nói rằng mô hình rẻ hơn ở mức cài đặt cao nhất chính là đối thủ của mô hình đắt ở phép đánh giá đó, và lợi thế của mô hình đắt chỉ hiện ra ở mức cài đặt cao nhất của chính nó.
Bảng benchmark của chính Anthropic nói gì
Anthropic công bố bảng mười một phép đánh giá so sánh Fable 5.2 với Fable 5.1, Opus 5.5, GPT-6 Astra và Gemini 4 Carbon. Sáu phép trong đó có số của cả năm mô hình, và đó là sáu phép được vẽ ở đây.
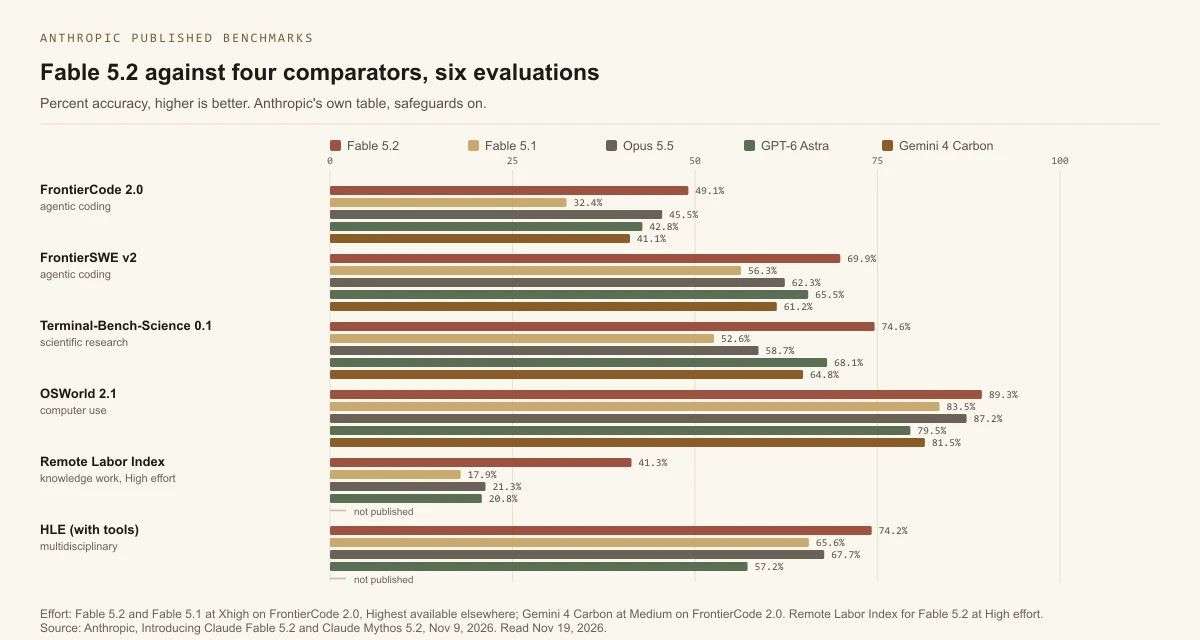
Fable 5.2 dẫn năm trong sáu. FrontierCode 2.0, phép đo xem thay đổi code của mô hình có được maintainer của dự án mã nguồn mở chấp nhận hay không, cho nó 49,1 phần trăm ở effort Xhigh so với 45,5 của Opus 5.5 và 41,1 của Gemini 4 Carbon ở mức Medium. FrontierSWE v2 cho nó 69,9 phần trăm so với 65,5 của GPT-6 Astra, mức gần nhất mà bất kỳ đối chiếu nào đạt được. Terminal-Bench-Science 0.1 cho nó 74,6 phần trăm, OSWorld 2.1 cho 89,3, và Humanity's Last Exam có dùng công cụ cho 74,2.
Hàng duy nhất nó không dẫn là AutomationBench, nơi Gemini 4 Carbon đạt 53,9 phần trăm so với 51,4 của Fable. Điều đó nên được nói thẳng thay vì chôn đi: mô hình của Google thắng phép đánh giá workflow doanh nghiệp trong chính bảng của Anthropic, hơn 2,5 điểm, và bất kỳ trang nào vẽ bảng này mà bỏ hàng đó là đang kể một câu chuyện chứ không phải tường thuật.
Hai phép đánh giá được công bố ở chỗ khác trong cùng bài ra mắt đáng một dòng riêng. Remote Labor Index đặt Fable 5.2 ở 41,3 phần trăm tại effort High so với 21,3 của Opus 5.5, và Humanity's Last Exam ở effort Low đạt ngang điểm cao nhất của Opus 5.5 với chi phí mỗi tác vụ dưới một phần mười. Chartography, phép đo việc đọc biểu đồ chứ không phải tạo biểu đồ, cho Fable 73,4 phần trăm ở effort cao nhất và 66,4 ở Medium, vẫn trên Opus 5.5 ở mức Max.
Các tuyên bố vận hành trong bài ra mắt là phần người mua không kiểm được từ bảng, và chúng được ghi là tuyên bố của Anthropic. Bài viết nói rằng một nhóm agent chạy phiên bản Fable trước đó đã chuyển một dịch vụ production quan trọng từ Python sang Rust, rằng hơn 90 phần trăm thay đổi được merge vào codebase lõi của Anthropic hiện do Claude viết với hướng dẫn của con người, và rằng một kỹ sư đã giao cho Fable 5.2 thiết kế một hệ điều hành nguyên mẫu từ thư mục rỗng, việc nó làm bằng cách điều phối hơn 1.000 subagent trong tám ngày. Không điều nào trong số đó là benchmark, và trang này không tái lập bất kỳ điều nào.
Một công cụ độc lập nói gì, và nó khắc nghiệt hơn
Artificial Analysis chạy một index chín phép đánh giá và tính giá từng lượt chạy, và số của nó kém nịnh hơn bảng của nhà cung cấp.
Fable 5.2 đạt 65 trên Intelligence Index v5.0.1, hạng nhất trong 96 mô hình, so với median của bộ đo là 43. Nó cũng tốn 26,54 đô la mỗi tác vụ index, tức hạng cuối trong 95 mô hình mà trang của nó xếp theo chi phí, và mất 41,8 phút mỗi tác vụ, so với median 12,1 phút. Thời gian đến token trả lời đầu tiên là 244,84 giây và tốc độ output 109 token mỗi giây. Trên toàn index nó sinh 275 triệu token output, nơi mô hình trung vị sinh 65,1 triệu.
Tổ hợp đó là hình dạng trung thực của mô hình: điểm cao nhất trên bộ đo, và cũng là cách đắt nhất, chậm nhất và dài dòng nhất để đạt nó. Trên Coding Agent Index riêng, chạy qua Claude Code ở effort Xhigh, nó đạt 58 với trung bình 15,47 đô la mỗi tác vụ, kém một điểm so với 59 của Gemini 4 Neon trên một harness khác, với chi phí mỗi tác vụ dưới một nửa. Con số đến từ harness nào không phải chú thích ở đây; nó là khác biệt giữa hai con số mà bài này đặt cạnh nhau.
Ba luật API làm hỏng một tích hợp đang chạy
Không luật nào trong số này là sở thích, và một tích hợp Fable 5.1 hiện có có thể vấp cả ba ngay lần gọi đầu.
Adaptive thinking luôn bật và không tắt được. Tham số effort là cách điều khiển duy nhất, và mặc định là high. Một client từng dựa vào việc tắt thinking giờ trả tiền cho suy luận ở mọi request dù có muốn hay không. Forced tool use trả lỗi 400 khi tool_choice là any hoặc chỉ đích danh một tool, nên một agent ghim tool phải để mô hình tự chọn. Và temperature, top_p, top_k phải bỏ hẳn: cung cấp bất kỳ cái nào cũng trả 400.
Có luật thứ tư không phải lỗi mà là quyết định mua sắm: để dùng được Fable 5.2, bạn phải chấp nhận lưu dữ liệu 30 ngày và không khả dụng dưới chế độ không lưu dữ liệu trừ khi Anthropic cho phép rõ ràng. Một nhóm đã chọn mô hình dựa trên cam kết không lưu dữ liệu phải mở lại câu hỏi đó trước khi chuyển, và phát hiện điều đó trong buổi review thiết kế rẻ hơn trong một cuộc audit.
Ai không nên dùng
Fable 5.2 không dành cho vòng agent khối lượng lớn. Gấp đôi giá Opus 5.5 ở cả hai chiều, với 275 triệu token dài dòng trên index, tạo ra hóa đơn mà bốn điểm index không phân bổ nổi qua hàng nghìn lần gọi mỗi ngày. Chính Anthropic nói điều đó trong bài ra mắt, nơi hãng khuyến nghị bắt đầu trên Opus 5.5.
Nó cũng không dành cho ai cần không lưu dữ liệu, hoặc cần đặt temperature, hoặc cần ghim một lần gọi tool, mà không có ngoại lệ từ Anthropic.
Nó dành cho lượt quyết định kiến trúc, cho cuộc điều tra xuyên file nơi một câu trả lời sai tốn hơn token, cho buổi review an ninh nơi phát hiện phải khai thác được chứ không chỉ nghe hợp lý, và cho tác vụ nghiên cứu dài hơi nơi 89,3 phần trăm trên computer use so với 79,5 của đối thủ gần nhất chính là toàn bộ lý do.
Chuyên mục AI coding của chúng tôi theo dõi các editor và agent mà những mô hình này cắm vào, hồ sơ Claude mang số liệu đã trích nguồn cho chính dải mô hình, so sánh Claude vs Gemini định giá cặp frontier cạnh tranh, và hướng dẫn Claude Code vs Cursor phủ lớp nơi lựa chọn mô hình gặp lựa chọn editor. Phân tích GPT-6.2 Astra vs Sol là cùng câu hỏi mua sắm cho cặp của OpenAI, và Claude Fable 5.2 vs Gemini 4 Neon đặt mô hình này cạnh sản phẩm mới nhất của Google trên một công cụ độc lập. Nếu phía Gemini là bên bạn đang định giá, Gemini 4 Neon mang giá và bảng riêng của nó.