Anthropic a lancé Claude Fable 5.2 le 9 novembre 2026, et la phrase la plus utile de sa propre documentation ne porte pas sur le modèle. Elle porte sur le routage : commencer la plupart des tâches de codage et de connaissance sur Claude Opus 5.5, puis monter vers Fable 5.2 quand la tâche le mérite. Chaque chiffre ci-dessous a été lu dans la documentation des modèles, la documentation tarifaire et l'annonce d'Anthropic, ainsi que dans la suite indépendante d'Artificial Analysis, le 19 novembre 2026.
Ce qu'Anthropic a livré, et ce que le frère moins cher achète
Fable 5.2 est le fer de lance de sixième génération pour le raisonnement exigeant et le travail agentique de longue haleine, avec une fenêtre de contexte de 1M de tokens et 128K tokens de sortie. Il accepte le texte et les images et renvoie du texte. Ses données d'entraînement et son seuil de connaissances fiables indiquent tous deux juin 2026, et Anthropic s'engage à le maintenir disponible pas avant le 9 novembre 2027.
Le frère est la partie que la plupart des lecteurs sautent. Claude Mythos 5.2 est le même modèle sous-jacent au même prix, et la différence tient à une porte plutôt qu'à une capacité : Fable est livré à tous les comptes avec des garde-fous en cybersécurité et en biologie, tandis que Mythos est réservé aux organisations vérifiées via les programmes Life Sciences et Cyber Verification d'Anthropic. Si votre travail relève de la sécurité offensive ou de la conception de protéines et que vous n'êtes dans aucun de ces programmes, le modèle que vous pouvez acheter est Fable, et ce sont précisément ces garde-fous qui expliquent pourquoi les scores des évaluations de cybersécurité sont publiés deux fois.
Le prix a baissé, et l'escalier autour compte davantage
Fable 5.2 facture 8 $ par million de tokens d'entrée et 40 $ par million de tokens de sortie. C'est 20 % sous les 10 $ et 50 $ de Fable 5.1, et la remise se répète sur chaque ligne de l'escalier de cache : 10 $ par million pour une écriture de cache de cinq minutes contre 12,50 $, 16 $ pour une écriture d'une heure contre 20 $, et 0,20 $ par million pour une lecture de cache contre 0,25 $.
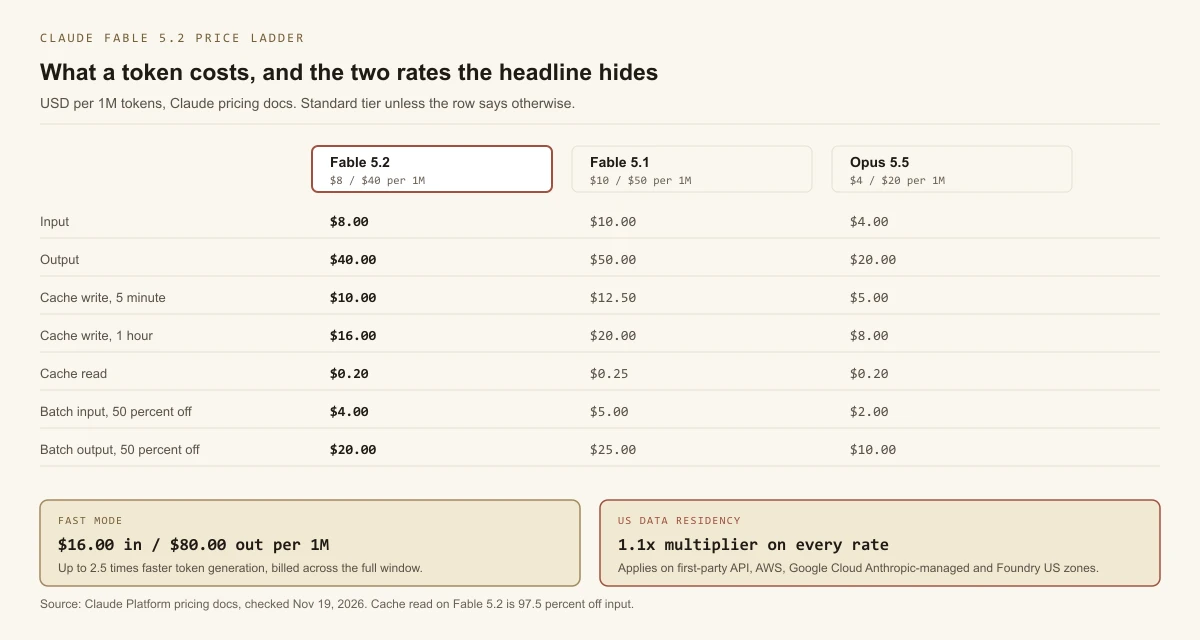
Trois lignes décident des factures réelles plus que le tarif d'affiche. D'abord, une lecture de cache coûte 97,5 % de moins que le tarif d'entrée, donc une charge de travail qui garde son préfixe de prompt stable paie 0,20 $ au lieu de 8,00 $ pour chaque million de tokens en cache, et c'est là que le conseil de routage cesse d'être une histoire de coût pour devenir une histoire d'architecture. Ensuite, la Batch API applique 50 % de remise dans les deux sens, ce qui place le travail batch à 4,00 $ d'entrée et 20,00 $ de sortie par million, exactement les tarifs qu'Opus 5.5 facture en interactif. Enfin, le mode Fast facture 16 $ d'entrée et 80 $ de sortie par million pour une génération de tokens jusqu'à 2,5 fois plus rapide, et il s'applique sur toute la fenêtre de contexte plutôt que sous un seuil.
Un multiplicateur de plus n'a pas de ligne à lui : envoyer l'inférence vers une géographie réservée aux États-Unis coûte 1,1 fois le tarif affiché sur l'API première partie, Claude Platform on AWS, le modèle géré par Anthropic sur Google Cloud et le US Data Zone Standard de Microsoft Foundry. Un budget qui suppose un routage mondial sera 10 % trop court dès qu'une exigence de conformité fixe la région.
La comparaison qui compte commercialement est celle avec Opus 5.5, facturé 4 $ et 20 $ avec un effort par défaut medium, et avec Sonnet 5.5 à 2 $ et 10 $ et Haiku 5.5 à partir de 0,10 $ et 0,50 $. Fable 5.2 coûte deux fois Opus 5.5 en entrée et deux fois en sortie. La prose de benchmark d'Anthropic elle-même est inhabituellement directe sur ce que cela achète : à l'effort High, Fable 5.2 marque à peu près au niveau d'Opus 5.5 à l'effort Max pour environ la moitié du coût par tâche. Lisez cette phrase deux fois, car elle dit que le modèle moins cher à son réglage le plus haut est le concurrent du modèle cher sur cette évaluation, et que l'avantage du modèle cher n'apparaît qu'à son propre réglage le plus haut.
Ce que montre le tableau de benchmarks d'Anthropic
Anthropic a publié un tableau de onze évaluations comparant Fable 5.2 à Fable 5.1, Opus 5.5, GPT-6 Astra et Gemini 4 Carbon. Six d'entre elles portent une valeur pour les cinq modèles, et ce sont les six tracées ici.
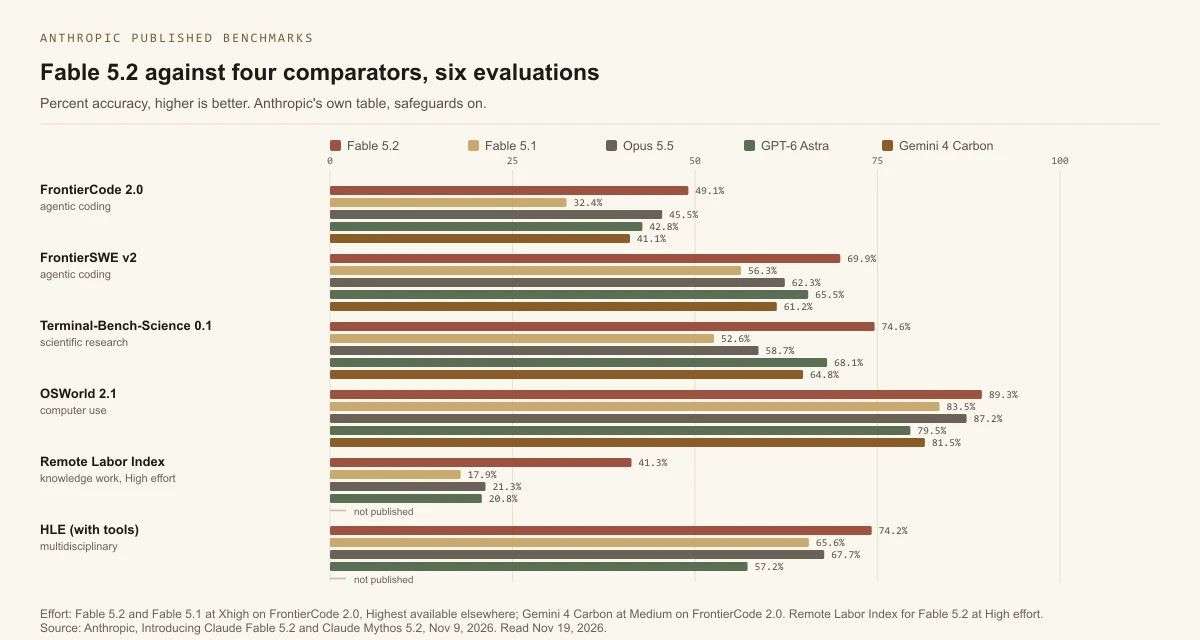
Fable 5.2 en mène cinq sur six. FrontierCode 2.0, qui mesure si les modifications de code d'un modèle seraient fusionnées par les mainteneurs de dépôts open source, lui donne 49,1 pour cent à l'effort Xhigh contre 45,5 pour Opus 5.5 et 41,1 pour Gemini 4 Carbon à Medium. FrontierSWE v2 lui donne 69,9 pour cent contre 65,5 pour GPT-6 Astra, le plus proche qu'atteigne un comparateur. Terminal-Bench-Science 0.1 lui donne 74,6 pour cent, OSWorld 2.1 lui donne 89,3, et Humanity's Last Exam avec outils lui donne 74,2.
La seule ligne où il ne mène pas est AutomationBench, où Gemini 4 Carbon marque 53,9 pour cent contre 51,4 pour Fable. Cela mérite d'être dit franchement plutôt qu'enterré : le modèle de Google gagne l'évaluation de workflow métier dans le tableau d'Anthropic lui-même, de 2,5 points, et toute page qui trace ce tableau en omettant cette ligne raconte une histoire au lieu de rapporter un résultat.
Deux évaluations publiées ailleurs dans la même annonce méritent une ligne chacune. Le Remote Labor Index place Fable 5.2 à 41,3 pour cent à l'effort High contre 21,3 pour Opus 5.5, et Humanity's Last Exam à l'effort Low égale le meilleur score d'Opus 5.5 pour moins d'un dixième du coût par tâche. Chartography, qui teste la lecture d'un graphique plutôt que sa génération, place Fable à 73,4 pour cent à son effort le plus haut et 66,4 à Medium, encore devant Opus 5.5 à Max.
Les affirmations opérationnelles de l'annonce sont celles qu'un acheteur ne peut pas vérifier depuis un tableau, et elles sont attribuées comme celles d'Anthropic. Elle indique qu'une équipe d'agents exécutant une version antérieure de Fable a migré un service de production critique de Python vers Rust, que plus de 90 pour cent des modifications fusionnées dans le dépôt central d'Anthropic sont désormais écrites par Claude avec des humains aux commandes, et qu'un ingénieur a demandé à Fable 5.2 de concevoir un système d'exploitation prototype depuis un dossier vide, ce qu'il a fait en coordonnant plus de 1 000 sous-agents sur huit jours. Rien de tout cela n'est un benchmark, et ce site n'en a reproduit aucun.
Ce que dit un instrument indépendant, plus sévère
Artificial Analysis fait tourner un indice de neuf évaluations et chiffre chaque exécution, et ses chiffres flattent moins que le tableau du fournisseur.
Fable 5.2 marque 65 sur l'Intelligence Index v5.0.1, premier sur 96 modèles, contre une médiane de suite de 43. Il coûte aussi 26,54 $ par tâche d'indice, soit dernier des 95 modèles que sa page classe par coût, et prend 41,8 minutes par tâche, contre une médiane de 12,1 minutes. Le temps avant le premier token de réponse est de 244,84 secondes et la vitesse de sortie de 109 tokens par seconde. Sur l'ensemble de l'indice, il a généré 275 millions de tokens de sortie là où le modèle médian en génère 65,1 millions.
Cette combinaison est la forme honnête du modèle : le meilleur score de la suite, et la manière la plus chère, la plus lente et la plus verbeuse de l'obtenir. Sur le Coding Agent Index séparé, exécuté via Claude Code à l'effort Xhigh, il marque 58 à une moyenne de 15,47 $ par tâche, un point derrière les 59 de Gemini 4 Neon sur un autre harnais, à moins de la moitié du coût par tâche. Le harnais d'où vient un chiffre n'est pas une note de bas de page ici ; c'est la différence entre deux des nombres que cet article place côte à côte.
Les trois règles d'API qui cassent une intégration qui marchait
Aucune n'est une préférence, et une intégration Fable 5.1 existante peut heurter les trois au premier appel.
La réflexion adaptative est toujours active et ne peut pas être désactivée. Le paramètre effort est le seul contrôle, et la valeur par défaut est high. Un client qui comptait désactiver la réflexion paie désormais du raisonnement à chaque requête, qu'il en veuille ou non. L'usage forcé d'un outil renvoie une erreur 400 quand tool_choice vaut any ou nomme un outil précis, donc un agent qui épinglait un outil doit laisser le modèle choisir. Et temperature, top_p et top_k doivent être omis : fournir l'un d'eux renvoie une erreur 400.
Une quatrième règle n'est pas une erreur mais une décision d'achat : Fable 5.2 exige une rétention des données de 30 jours et n'est pas disponible sans rétention sauf autorisation expresse d'Anthropic. Une équipe qui a choisi un modèle sur une promesse de rétention nulle doit rouvrir cette question avant de basculer, et il coûte moins cher de le découvrir en revue de conception qu'en audit.
Pour qui ce n'est pas fait
Le modèle Fable 5.2 n'est pas fait pour les boucles agentiques à fort volume. Deux fois le tarif d'Opus 5.5 dans les deux sens, avec 275 millions de tokens de verbosité sur l'indice, produit une facture qu'un gain de quatre points d'indice n'amortit pas sur des milliers d'appels quotidiens. Anthropic le dit elle-même dans l'annonce, qui recommande de commencer sur Opus 5.5.
Il n'est pas non plus fait pour qui a besoin d'une rétention nulle, ou d'un réglage de température, ou d'un appel d'outil épinglé, sans exception d'Anthropic.
Il est fait pour le tour qui décide de l'architecture, pour l'investigation multi-fichiers où une mauvaise réponse coûte plus que les tokens, pour la revue de sécurité où la trouvaille doit être exploitable plutôt que plausible, et pour la tâche de recherche de longue haleine où 89,3 pour cent en usage informatique contre 79,5 pour le concurrent le plus proche est toute la raison d'être.
Notre catégorie codage IA suit les éditeurs et agents auxquels ces modèles se branchent, le profil Claude porte les chiffres sourcés de la gamme elle-même, la comparaison Claude vs Gemini tarife la paire frontière concurrente, et le guide Claude Code vs Cursor couvre la couche où le choix du modèle rencontre celui de l'éditeur. L'analyse GPT-6.2 Astra vs Sol pose la même question d'achat pour la paire d'OpenAI, et Claude Fable 5.2 vs Gemini 4 Neon place ce modèle face au plus récent de Google sur un même instrument indépendant. Si le camp Gemini est celui que vous chiffrez, Gemini 4 Neon porte ses propres tarifs et son propre tableau.