Deux modèles frontière, lancés à neuf jours d'intervalle, à un facteur 2,67 de prix par token et mesurés sur un même instrument indépendant. Claude Fable 5.2 marque 65 sur l'Intelligence Index d'Artificial Analysis et coûte 26,54 $ par tâche ; Gemini 4 Neon marque 61 et coûte 6,44 $. Quatre points d'indice les séparent, et 4,1 fois le coût aussi. Chaque chiffre ici a été lu dans les documents des deux fournisseurs et dans Artificial Analysis, le 19 novembre 2026.
La comparaison d'affiche, et pourquoi elle n'est pas toute l'histoire
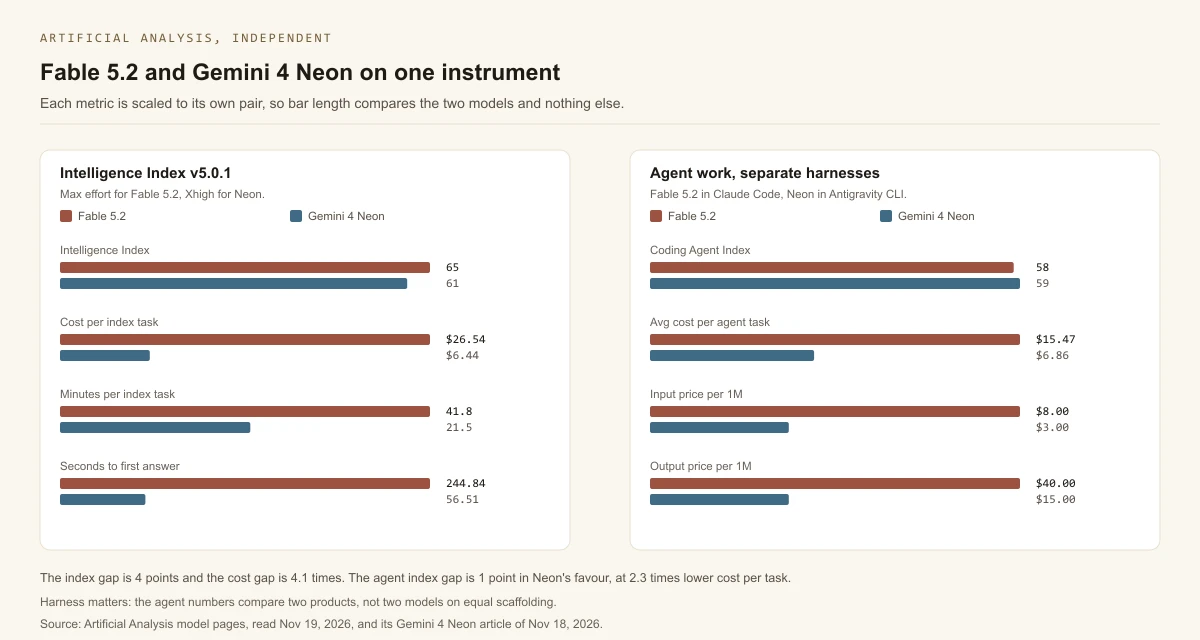
Sur l'indice, l'écart est de quatre points. Sur le coût par tâche il est de 4,1 fois, et sur le temps par tâche de 41,8 minutes contre 21,5. Le temps avant le premier token de réponse est de 244,84 secondes contre 56,51, et c'est le nombre qui décide si un modèle peut tenir dans une boucle interactive.
Ces quatre nombres relèvent du même instrument, de la même suite et de la même méthodologie publiée, ce qui les rend comparables d'une manière que les tableaux de deux fournisseurs ne le sont pas. Ce qu'ils ne sont pas, c'est une affirmation sur votre charge de travail : un indice de neuf évaluations mesure les modèles, et l'usage honnête consiste à lancer les deux prompts qui vous importent vraiment avant de déplacer un budget.
Une paire de plus mérite de figurer à côté, car elle change la forme de la réponse. Sur l'ensemble de l'indice, Fable 5.2 a généré 275 millions de tokens de sortie et Neon 283 millions, contre 65,1 millions pour un modèle médian. Les deux sont extraordinairement verbeux sur cette suite, donc l'écart de coût n'est pas une différence de verbosité ; c'est le prix du token.
Le chiffre sur l'étiquette n'est pas toute la facture
8,00 et 40,00 contre 3,00 et 15,00, c'est un rapport de 2,67 dans les deux sens, et c'est là que la plupart des comparaisons s'arrêtent. Ce n'est pas le nombre qui décide d'une facture.
La lecture de cache de Fable 5.2 est à 0,20 $ par million, une remise de 97,5 % sur son tarif d'entrée de 8,00 $, et sa Batch API applique 50 % dans les deux sens. L'entrée en cache de Neon est à 0,15 $ et ses paliers Batch et Flex appliquent 50 %. Une charge de travail avec un préfixe de prompt stable et un calendrier de type batch comprime fortement les deux prix, et elle comprime celui de Fable plus fort en dollars absolus parce que son point de départ est plus haut.
Neon porte deux limites structurelles à nommer dans la même phrase. Il n'y a pas de palier gratuit, donc chaque évaluation coûte de l'argent dès le premier appel, et le cache explicite n'est pris en charge sur aucun palier, donc le schéma de gestion manuelle du cache est indisponible. Fable 5.2 porte une limite structurelle différente : une rétention des données de 30 jours est exigée, et la rétention nulle n'est pas disponible sans autorisation expresse d'Anthropic.
Là où les deux éditeurs publient un chiffre pour la même épreuve
Cinq évaluations apparaissent dans la documentation des deux éditeurs avec une valeur pour chaque modèle. Elles sont tracées ensemble ici parce que ce sont les seules lignes où une comparaison n'exige pas de faire confiance au choix de comparateurs d'un camp.
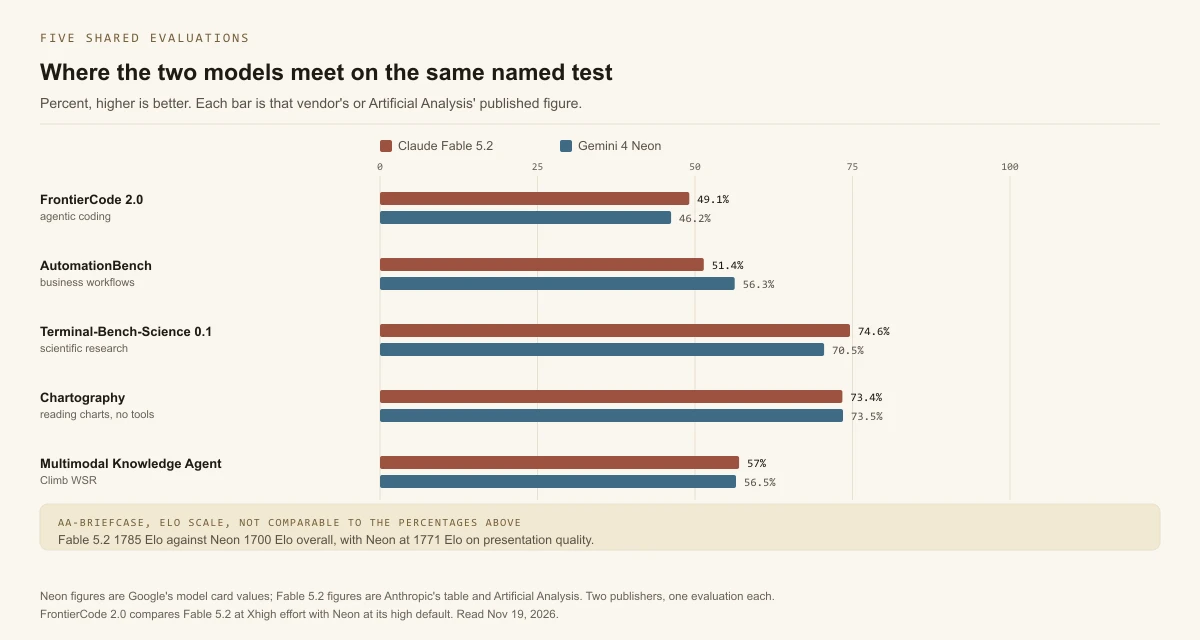
Fable 5.2 en mène trois sur cinq. FrontierCode 2.0 lui donne 49,1 pour cent à Xhigh contre 46,2 pour Neon à son réglage high par défaut. Terminal-Bench-Science 0.1 lui donne 74,6 contre 70,5. Multimodal Knowledge Agent lui donne 57 pour cent selon Artificial Analysis contre 56,5 pour Neon.
Neon en mène deux. AutomationBench lui donne 56,3 pour cent contre 51,4, un écart de 4,9 points qui est le plus grand dans un sens comme dans l'autre sur cet ensemble. Et Chartography les sépare d'un dixième de point, 73,5 contre 73,4, ce qui n'est pas une différence sur laquelle router du travail.
La paire AA-Briefcase appartient à cette page mais pas à cette échelle en pourcentage : 1785 Elo pour Fable 5.2 contre 1700 pour Neon au total, avec Neon à 1771 en qualité de présentation. Un nombre Elo et un pourcentage ne partagent pas d'unité, et les placer sur un même axe est le genre de graphique qui paraît rigoureux et ne dit rien.
Deux mises en garde valent pour chaque ligne. D'abord, les niveaux d'effort diffèrent entre les réglages des deux éditeurs, et la note du graphique dit lesquels. Ensuite, FrontierCode 2.0 mesure si des modifications de code seraient fusionnées, donc un modèle exécuté dans un harnais d'agent plus fort s'attribue une part du mérite du harnais plutôt que du sien.
Le problème du harnais, où la plupart des comparaisons se trompent
Les deux éditeurs publient un chiffre de Coding Agent Index d'Artificial Analysis, et les trois scores sont 58, 58 et 59.
Fable 5.2 à Xhigh dans Claude Code marque 58 à 15,47 $ par tâche. Claude Opus 5.5 à Max marque 58 à 12,61 $. Gemini 4 Neon à Xhigh dans Antigravity CLI marque 59 à 6,86 $. L'annonce de Google énonce son propre chiffre à 58,6 et l'appelle premier au classement général.
Trois modèles, trois harnais, trois prix, et un écart d'un point. Toute phrase qui se lit « Neon bat Fable 5.2 sur les agents de codage » est vraie telle qu'écrite et trompeuse telle que comprise, car la comparaison porte sur deux produits plutôt que sur deux modèles à échafaudage égal. La colonne des prix est la partie qui survit à la mise en garde : 6,86 $ contre 15,47 $ est une différence réelle mesurée sur la même suite, et elle est mesurée à l'intérieur du harnais de chaque éditeur, ce qui est la façon dont un client l'exécuterait réellement.
Où chacun gagne la différence
Fable 5.2 la gagne sur les tours où avoir raison compte plus que coûter peu. OSWorld 2.1 lui donne 89,3 pour cent en usage informatique, et l'avance de quatre points d'indice se concentre dans les évaluations qu'Anthropic classe en codage agentique, science et raisonnement multidisciplinaire. Sa propre documentation recommande de commencer sur Opus 5.5, moins cher, et d'escalader, ce qui est un fournisseur qui vous dit où son fer de lance ne vaut pas son prix.
Neon la gagne sur le volume, le contexte long et l'autonomie contrainte par le coût. GraphWalks lui donne 95,2 pour cent de 256K à 1M de tokens là où le comparateur le plus proche marque 80,1, son avance sur AutomationBench est de 4,9 points, et 6,86 $ par tâche d'agent contre 15,47 $ change le nombre de tâches qu'un budget peut se permettre de lancer sans surveillance.
Pour qui ne devrait choisir ni l'un ni l'autre
Si la charge de travail est du codage quotidien sur budget, aucun des deux n'est la première réponse : Anthropic recommande Opus 5.5 et Google positionne Neon lui-même comme le créneau valeur d'une gamme qui vend aussi Carbon et Hydrogen. La comparaison honnête pour un acheteur de volume est Fable 5.2 face à Opus 5.5, et Neon face au tarif de décembre de Carbon plutôt qu'à sa promotion de novembre.
Si la charge exige une rétention nulle, Fable 5.2 est écarté jusqu'à ce qu'Anthropic autorise une exception. Si elle exige un contrôle explicite du cache, Neon est écarté sur tous les paliers.
Notre catégorie codage IA suit les éditeurs et agents dans lesquels les deux modèles se branchent, les profils Claude et Gemini portent les chiffres sourcés de chaque gamme, et la comparaison Claude vs Gemini tarife la paire frontière plus ancienne. Les lectures autonomes sont Claude Fable 5.2 et Gemini 4 Neon, l'analyse Gemini 4 Carbon vs Hydrogen couvre les deux modèles entre lesquels Neon a été inséré, et l'analyse GPT-6.2 Astra vs Sol pose la même question d'achat pour la paire d'OpenAI.