Google a lancé Gemini 4 Neon le 18 novembre 2026, le quatrième modèle Gemini 4 en sept semaines et celui positionné entre Carbon et Hydrogen. Il coûte 3,00 $ par million de tokens d'entrée et 15,00 $ par million de tokens de sortie, porte une fenêtre unifiée de 1M de tokens, et sur le tableau publié par Google lui-même il gagne une évaluation face à ses comparateurs nommés et en perd une autre. Chaque chiffre ci-dessous a été lu dans l'annonce de Google, la fiche modèle de DeepMind, la page tarifaire de l'API Gemini, et la page modèle et l'article d'Artificial Analysis, le 19 novembre 2026.
Ce qu'est Neon, selon le positionnement de Google
Neon est adapté de Gemini 4 Carbon, et c'est la phrase qui explique tout le produit. Ce n'est pas une nouvelle architecture ; c'est la lignée Carbon avec un autre équilibre entre profondeur et vitesse, placée sous Carbon pour le travail de longue haleine le plus dur et au-dessus d'Hydrogen pour l'exécution quotidienne. Les entrées sont le texte, l'image, l'audio, la vidéo et le PDF, la sortie est du texte, et le seuil de connaissances est mars 2026.
La fenêtre a un détail qui mérite une lecture attentive, car il est facile de le citer de travers. La fiche modèle décrit une fenêtre unifiée d'entrée et de sortie allant jusqu'à 1M de tokens, avec jusqu'à 64K de sortie synchrone par défaut et jusqu'à 1M via un long décodage en arrière-plan. C'est une seule fenêtre partagée entre le prompt et la réponse, pas une fenêtre d'entrée de 1M plus une allocation de sortie séparée, et une requête qui veut une sortie longue échange de l'espace de prompt contre elle.
La réflexion tourne à quatre niveaux : low, medium, high et xhigh. La page tarifaire de Google facture les tokens de réflexion, ce qui signifie que le niveau choisi est une décision de coût autant que de qualité, et le cadrage de l'annonce indique que xhigh est destiné aux charges de travail techniques, analytiques et scientifiques les plus dures.
Le prix, palier par palier
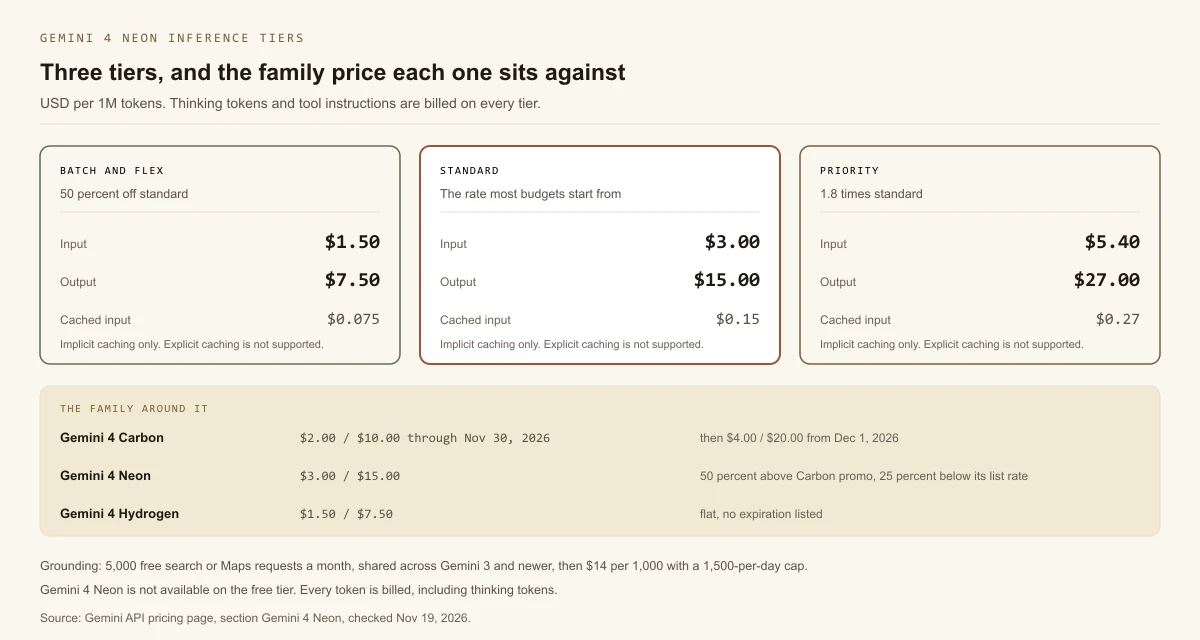
Standard est à 3,00 et 15,00. Batch et Flex appliquent 50 % de remise, à 1,50 et 7,50. Priority coûte 1,8 fois le standard, à 5,40 et 27,00. L'entrée en cache est à 0,15 $ par million au palier standard, une remise de 95 %, et la mise en cache est implicite uniquement : le cache explicite n'est pris en charge sur aucun palier, ce qui écarte le schéma de gestion manuelle du cache que certaines équipes construisent autour.
Trois faits de facturation sont faciles à manquer et coûteux à manquer. Il n'y a pas de palier gratuit sur l'API Gemini, donc l'évaluation coûte de l'argent dès le premier appel. Chaque token est facturé, y compris les tokens de réflexion et les instructions système d'outils internes et déclarations de fonctions qu'ajoute le grounding. Et le grounding avec Google Search ou Maps inclut 5 000 requêtes gratuites par mois partagées entre Gemini 3 et plus récents, puis 14 $ par 1 000 requêtes, avec un plafond de 1 500 par jour sur le grounding Search.
Le prix n'a de sens qu'à côté de ses frères. Carbon est à 2,00 et 10,00 jusqu'au 30 novembre 2026 et à 4,00 et 20,00 à partir du 1er décembre. Les 3,00 et 15,00 de Neon se situent 50 % au-dessus du tarif promotionnel de Carbon et 25 % sous son tarif standard de 4,00 et 20,00. Hydrogen est à 1,50 et 7,50, sans date d'expiration indiquée.
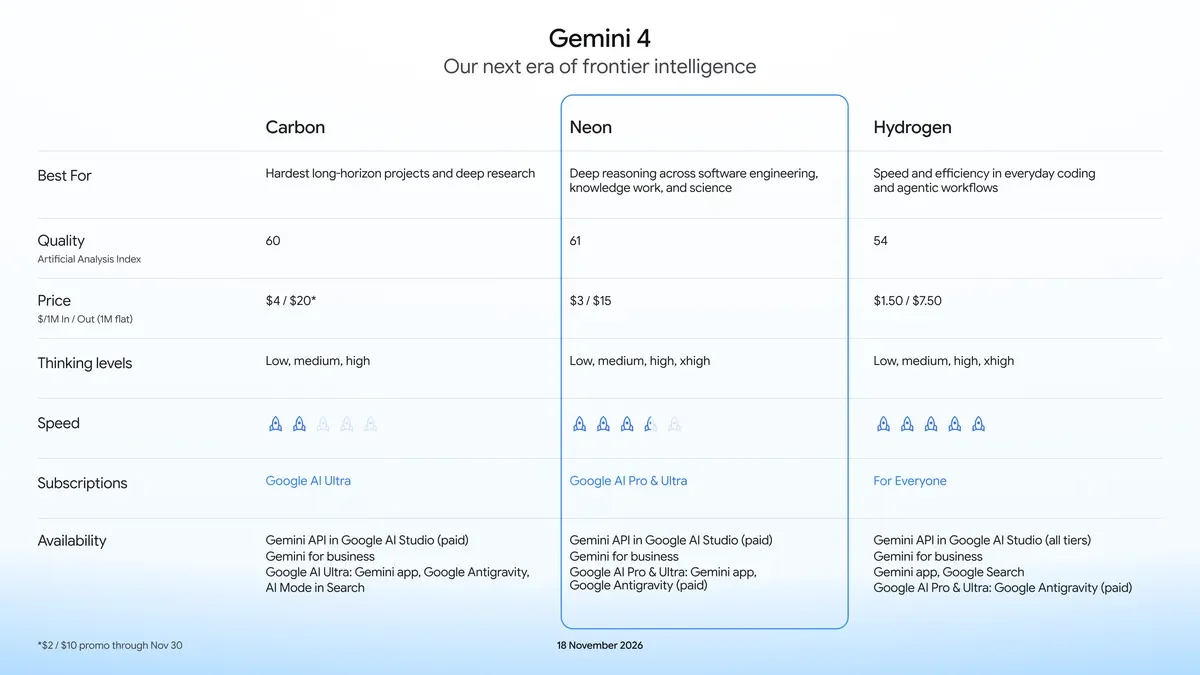
Ce placement est la décision d'achat en une ligne : Neon est le modèle que vous chiffrez face au tarif de décembre de Carbon, pas face à celui de novembre. Une équipe qui compare Neon à la promotion actuelle de Carbon et conclut qu'il est cher le compare à une remise qui expire dans douze jours.
Ce que montre le tableau de Google
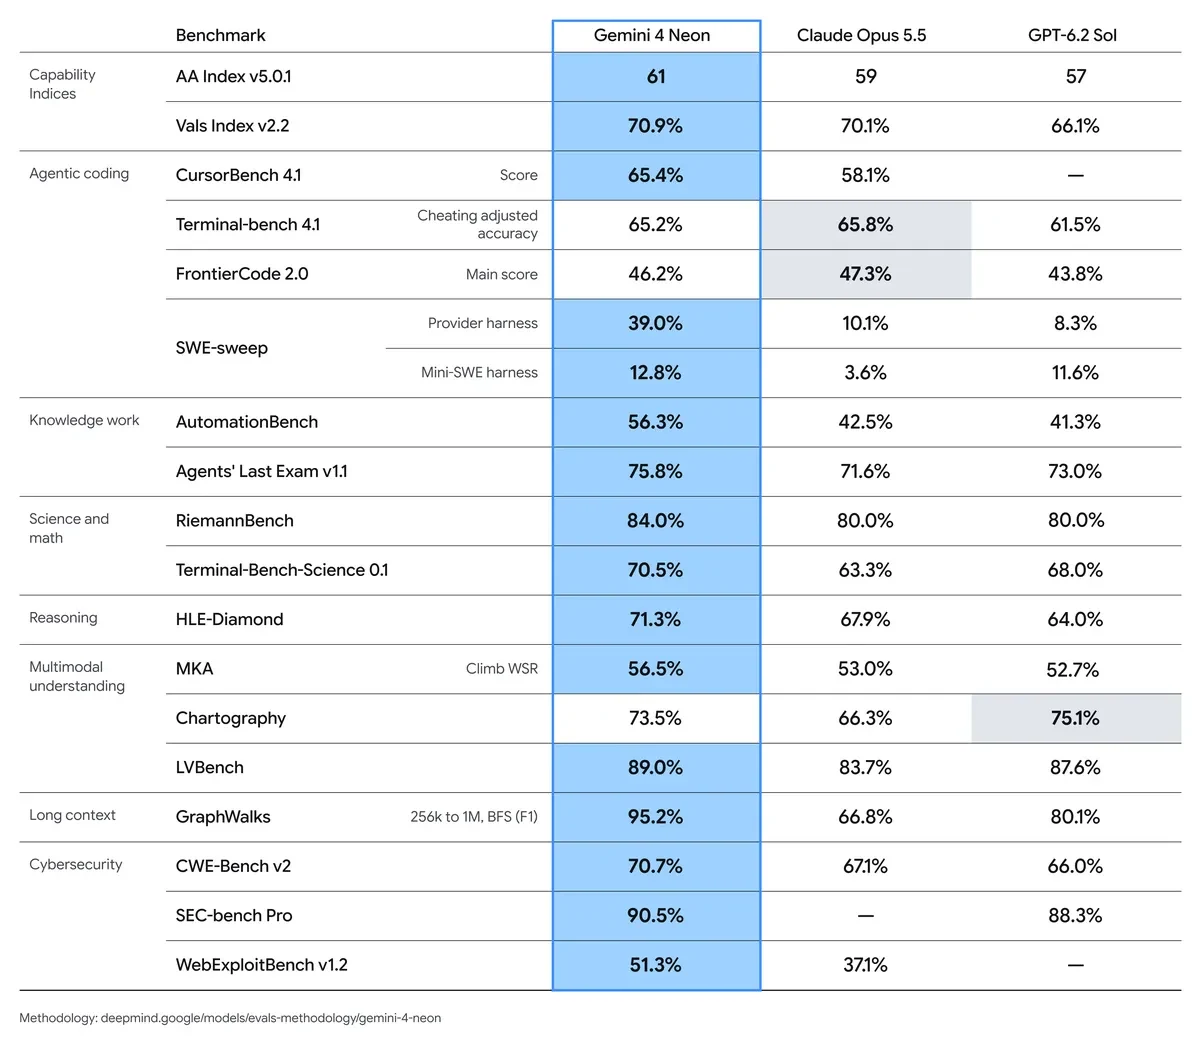
La fiche modèle de Google déroule dix-neuf évaluations face à Claude Opus 5.5 et GPT-6.2 Sol, et Neon en gagne la plupart. AutomationBench lui donne 56,3 pour cent contre 42,5 et 41,3, et Google décrit cela comme une première place globale. GraphWalks, qui mesure la récupération sur 256K à 1M de tokens, lui donne 95,2 pour cent contre 66,8 et 80,1, le plus grand écart du tableau. LVBench lui donne 89,0, HLE-Diamond 71,3, RiemannBench 84,0, SEC-bench Pro 90,5 et WebExploitBench v1.2 51,3.
Une ligne va dans l'autre sens et c'est celle qu'une page comme celle-ci est tentée d'omettre : Chartography place GPT-6.2 Sol à 75,1 pour cent contre 73,5 pour Neon. C'est une perte de 1,6 point sur la lecture de graphiques denses, et elle figure dans un tableau que Google a lui-même publié.
Les lignes de codage sont là où la question du harnais apparaît. CursorBench 4.1 donne à Neon 65,4 pour cent contre 58,1 pour Opus 5.5. Terminal-bench 4.1 va dans l'autre sens, 65,2 contre 65,8. FrontierCode 2.0 donne à Neon 46,2 à son réglage high par défaut contre 47,3 pour Opus 5.5. SWE-sweep est la paire frappante : 39,0 pour cent dans le harnais du fournisseur contre 10,1 pour Opus 5.5, et 12,8 pour cent sur le harnais mini-SWE contre 3,6. Ces deux harnais divergent d'un facteur trois sur le même modèle, et c'est la preuve la plus claire de la page qu'un score est une affirmation sur un harnais autant que sur un modèle.
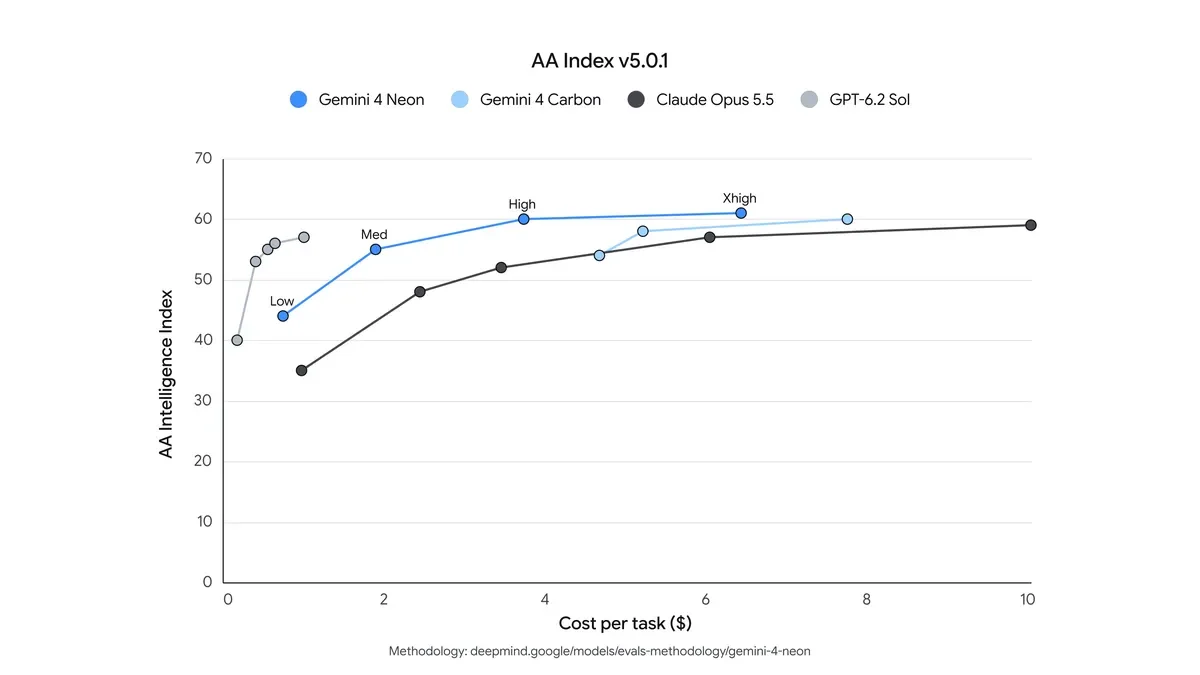
Le cadrage de Google pour ce lancement porte sur le coût contre l'intelligence plutôt que sur le score brut : l'annonce dit que Neon associe un score d'indice élevé à un coût par tâche inférieur de 32 % à celui de Carbon à son niveau high par défaut, et qu'à high il se place sur la frontière de Pareto du Vals index et de l'Agent Arena à un coût par tâche inférieur d'environ 50 à 80 % aux principaux modèles frontière concurrents.
Ce que dit l'instrument indépendant
Artificial Analysis note Neon à 61 sur l'Intelligence Index v5.0.1 à l'effort Xhigh, soit troisième au classement général le jour du lancement derrière GPT-6.2 Astra et Claude Fable 5.2 et un point devant Carbon à 60. Au 19 novembre, avec davantage de configurations d'effort classées, sa page modèle affiche sixième sur 96.
Il coûte 6,44 $ par tâche d'indice contre 7,76 $ pour Carbon au tarif non remisé, environ 17 % de moins malgré la génération d'environ 15 % de tokens de sortie en plus, et toute cette économie vient du prix de token inférieur de 25 %. Il prend 21,5 minutes par tâche, environ 21 contre 36 pour Carbon, et tourne à 110 tokens de sortie par seconde contre 57 pour Carbon. Le temps avant le premier token de réponse est de 56,51 secondes. Sur l'ensemble de l'indice, il a généré 283 millions de tokens de sortie, ce qui est verbeux face aux 65,1 millions d'un modèle médian.
Les chiffres d'agent sont les plus pertinents commercialement et les plus faciles à mal lire. Neon à Xhigh dans Antigravity CLI marque 59 sur le Coding Agent Index à 6,86 $ par tâche. Claude Fable 5.2 à Xhigh dans Claude Code marque 58, et Opus 5.5 à Max marque 58, tous deux à plus du double du coût par tâche de Neon. L'annonce de Google énonce son propre chiffre à 58,6 et le classe premier au classement général. Les deux affirmations sont vraies telles qu'écrites et aucune n'est une comparaison de modèles sur un échafaudage identique : trois modèles, trois harnais, et l'article que vous lisez détermine lequel est appelé leader.
Au-delà de l'indice, Artificial Analysis rapporte 33,4 pour cent pour Neon à high sur GDP.pdf contre 28,4 pour Carbon, et 1700 Elo au total sur AA-Briefcase avec 1771 Elo en qualité de présentation, 45 points devant le précédent leader.
Où il gagne, et où il ne gagne pas
Neon gagne sur le contexte long avec une marge qu'aucune ligne de son tableau n'approche : 95,2 pour cent sur GraphWalks de 256K à 1M de tokens, où les deux comparateurs marquent 66,8 et 80,1. Si votre travail consiste à retrouver un fait dans un million de tokens, cette ligne est la raison de le choisir, et le prix est la raison pour laquelle vous pouvez vous le permettre.
Il gagne sur les évaluations de workflow métier, sur le coût par tâche face à Carbon, et sur la vitesse de sortie face à Carbon. Il gagne sur les benchmarks de cybersécurité à des niveaux absolus étonnamment élevés pour un modèle de milieu de gamme, avec 90,5 pour cent sur SEC-bench Pro, et Google déploie une variante cyber dans le cadre de son programme Fairwind pour les défenseurs de confiance.
Il ne gagne pas sur la lecture de graphiques, où GPT-6.2 Sol le devance de 1,6 point. Il ne gagne pas au sommet de l'indice d'intelligence, où Fable 5.2 le devance de quatre points. Et il ne gagne pas sur la souplesse du cache, car il n'a aucun cache explicite.
Pour qui ce n'est pas fait
Neon n'est pas fait pour une équipe qui a besoin d'un contrôle explicite du cache, car le modèle ne l'offre pas. Il n'est pas fait pour une équipe sans budget d'évaluation, car il n'y a pas de palier gratuit. Il n'est pas fait pour le tour unique qui doit être juste à tout prix, car à quatre points d'indice derrière le leader, ce tour revient au modèle plus cher.
Il est fait pour les boucles de codage quotidiennes où son coût par tâche d'agent face à la paire frontière change ce que vous pouvez vous permettre d'automatiser. Il est fait pour la récupération en contexte long où la ligne GraphWalks à 95,2 pour cent est tout le produit. Et il est fait pour la flotte d'agents plafonnée en coût où le prix par tâche est la contrainte plutôt que le plafond.
Notre catégorie codage IA suit les outils que ces modèles alimentent, le profil Gemini porte les chiffres sourcés de la gamme, et la comparaison Claude vs Gemini tarife la paire frontière concurrente. L'analyse Gemini 4 Carbon vs Hydrogen couvre les deux modèles entre lesquels Neon a été inséré, et Claude Fable 5.2 vs Gemini 4 Neon place ce modèle face au fer de lance d'Anthropic sur un même instrument indépendant. L'analyse Claude Fable 5.2 est la lecture autonome de ce fer de lance, et l'analyse GPT-6.2 Astra vs Sol pose la même question d'achat pour la paire d'OpenAI.